Seedance 2.0 说唱视频表现解析:它擅长什么
 AI Rap Video Team
从动作、人物相似度、灯光、文字到最适合的镜头类型,实用解读 Seedance 2.0 在说唱表演片段中的表现,并如实说明其局限。
Seedance 2.0 是这款工作室背后的视频模型。它擅长短小、具有电影感的表演镜头:布料随身体摆动,彩色光线穿过薄雾,镜头推进而不丢失主体。它不是音乐视频引擎。弄清楚这句话中哪一半适用于你的创意,可以节省积分。
本指南关注的是该模型在说唱特定镜头中的行为。它不是基准测试,也与模型制造商无关。以下所有内容都来自本工作室提供的镜头类型以及这些镜头产生的失败模式。
模型擅长什么
光线与氛围。 彩色实用光源、薄雾、轮廓光和湿润表面都能逼真渲染。俱乐部舞台或夜晚屋顶能为模型提供足够的视觉信息,构建出一个可信的空间。
布料与剪影。 连帽衫、夹克和宽松衣物随身体运动。这在说唱视觉中很重要,因为剪影往往和面部一样承载态度。
单一镜头运动。 推镜、横向跟踪或缓慢环绕在主体保持在画面内时效果良好。运动足够平滑,感觉像被导演过,而非生成出来的。
短表演节拍。 点头、手势、朝镜头迈一步、转向镜头。这些在五到十二秒内清晰可读,而这正是工作室所售卖的格式。
模型不擅长什么
文字。 招牌、标签、带字母的纹身和屏幕歌词都会退化。模型能生成远看像文字、近看变成乱码的东西。每个预设都排除可读文字,原因就在于此。
特写中的手。 手指是最常见的失败点。让手放在麦克风上、插在口袋里,或移动得足够快,使观众不会仔细端详。
精确对口型。 模型不会接收你的人声干声,也无法与之同步。表演片段看起来像表演;它看起来不像配音。在编辑器中加入音轨,并围绕不匹配处进行剪辑。
多镜头连续性。 一次渲染就是一个镜头。在同一个片段中要求切换、更换地点和更换服装,会产生一团糊。分别生成各个镜头,再进行剪辑。
真实、可识别的人物。 涉及名人或公众人物的请求会被拒绝,未经同意使用真实人物的肖像也是不允许的。只上传同意出镜的人。
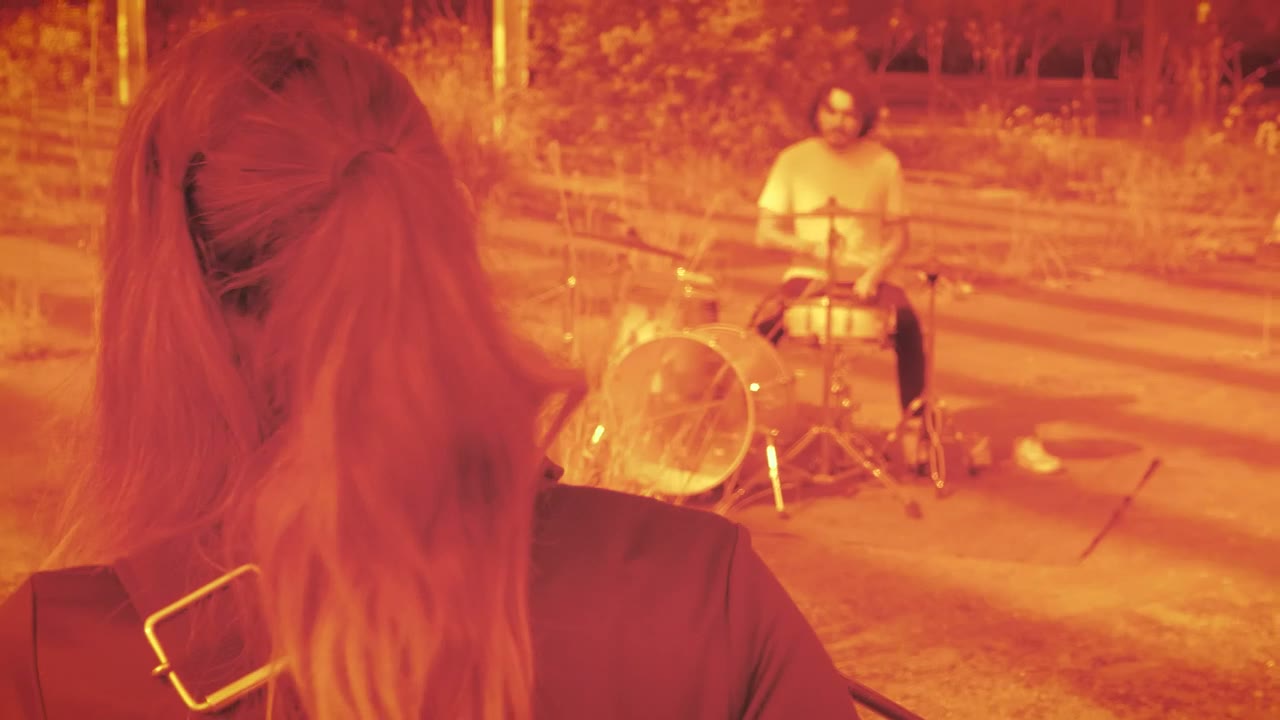
适合该模型的镜头类型
预设是围绕模型的优势选择的,而不是围绕任意罗列的音乐视频套路:
- 俱乐部双人镜头。 两位表演者,剪影中的观众,手持推镜。背景繁忙,但面部较大。
- 电话亭特写。 一位表演者,一支麦克风,暖色主光和冷色轮廓光。最简单的身份测试,也是最可靠的镜头。
- 屋顶自由说唱。 一位主角,一圈剪影,湿混凝土上的钠灯。足够构建世界,而不要求观众个体的面部。
- 复古人行道。 两位表演者,一台手提音响,温暖的胶片颗粒。时代细节仅限于模型能拿住的物体:砖墙、服装、手提音响。
每个预设都保持运动部件数量低。这就是设计原则:更少的物体,更少的身份,一次镜头运动。
顺应模型而非对抗模型来写提示词
按照模型权重的顺序来写镜头:主体、地点、光线、镜头、约束。把身份指令放在前面,并在结尾重复。使用朴素的物理语言——"左侧暖钨丝主光"、"缓慢推镜"、"胸部高度"——而不是美学标签。
避免纯否定式提示词。"无模糊、无畸变"并没有告诉模型要渲染什么。先说有什么,再说不能出现什么。预设两者都做。
测试时保持片段短小。720p 的五秒渲染是了解一张照片和一个场景是否契合的最便宜方式。一旦身份保持稳定,再以更长时长和更高分辨率重新渲染胜出的版本。
肖像相似度:可以期待什么
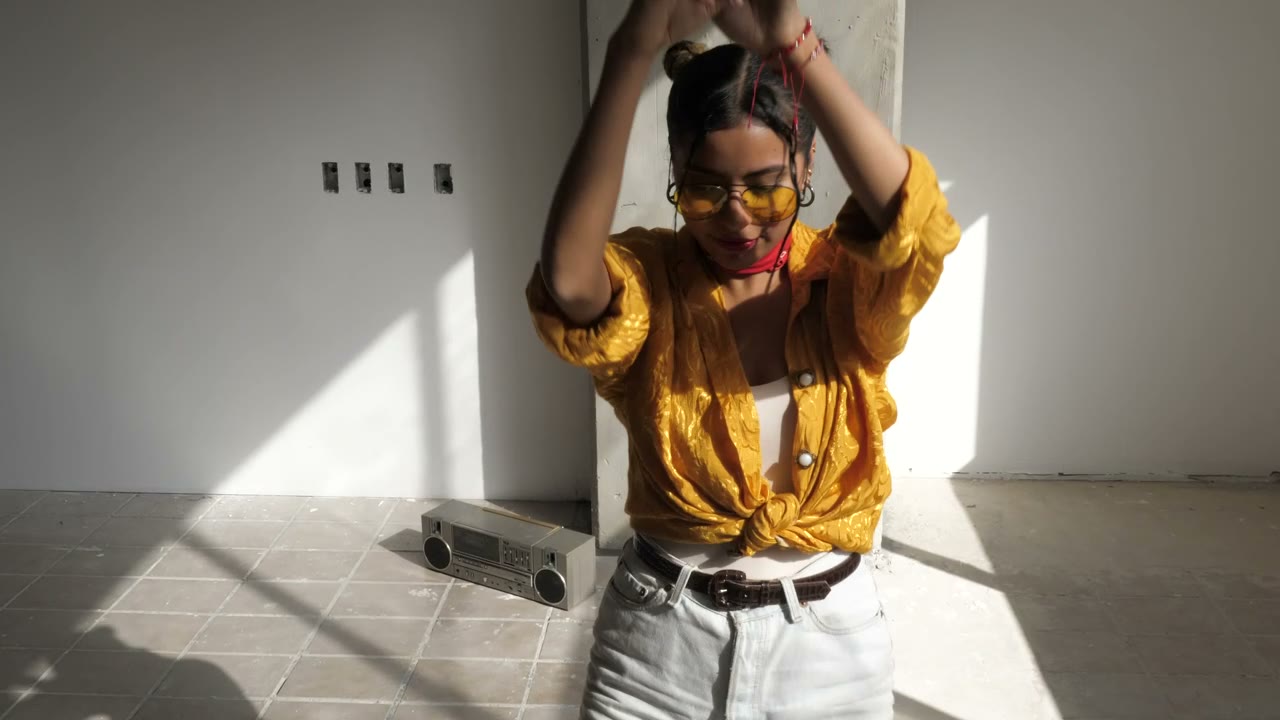
模型将你的照片用作参考,而非扫描。清晰的正脸肖像能产生强烈的相似度。柔焦照片、遮挡面部或重度滤镜会产生漂移,而再多的提示词文本也无法修复一张已经丢失信息的源图。
最可靠的改进是一张更好的照片:均匀光线、眼睛可见、发际线可见、中性表情。第二可靠的是更慢的镜头运动。第三是更简单的场景。提示词措辞排第四。
实践中的成本与时长
工作室按分辨率和时长定价,并在提交任务前显示成本。标准的 720p 十二秒片段是定价页面上的参考单位。更短的片段成本更低;1080p 成本更高。没有免费层级,因此预览和价格是同一个决策的一部分。
大多数片段在几分钟内完成。1080p 渲染可能需要更长时间。你可以离开页面再回来;任务会存储在你的账户下。
预设编码了什么
每个工作室预设都是一条完整提示词,而不是滤镜。Duo Stage 编码了两位表演者、一个俱乐部、薄雾、品红色实用光源和手持推镜。Solo Booth 编码了一位表演者、一支麦克风、暖色主光和冷色轮廓光,以及缓慢推镜。Night Cypher 编码了一位主角、一圈剪影和湿混凝土上的钠灯。Retro VHS 编码了两位表演者、一台手提音响、温暖的颗粒和轻微的光晕。
把它们当作范例来读。结构是一致的:主体、地点、光线、镜头、约束。一旦你看到这个模式,你就可以写出第五个预设,而不用猜测模型对哪些词有反应。
这些提示词还展示了模型没有被要求做什么。它们都没有要求切换、歌词、标志或对口型特写。这些省略是刻意的,也正是预设能可靠渲染的原因。
何时使用不同的工具
如果你需要与成品人声对口型的表演,那这个工具不合适。如果你需要十分钟的视觉化视频,生成一个循环并在编辑器中重复。如果你需要真实的产品、真实的场地或真实的人群,去实拍。当世界可以被发明,而表演者是画面中唯一真实的东西时,Seedance 最为强大。
关于该模型的工作流程,请阅读如何制作 AI 说唱视频。关于提示词,请使用12 条提示词库。