AI 说唱双人视频指南:两张面孔,同一场景
 AI Rap Video Team
如何用两张照片生成可信的说唱双人视频:匹配光线、安排走位、确定谁主导、避免换脸,以及如何剪辑成片。
双人视频并不是在单人片段里再添一个人那么简单。整个画面取决于两位表演者之间的关系:谁在左边,谁主导,两人相距多远,以及镜头把他们放在什么位置。把这种走位安排对了,一段五秒的片段就能读出一个场景。安排错了,你就只是让两个人并排站着,等着被指挥。
本指南涵盖从两张照片生成说唱双人视频时真正重要的决策,以及双人渲染特有的失败模式。
从两张照片开始,而不是一张合影
工作室每位表演者只接受一张照片。分开的照片比合影更好,因为每张脸都能获得自己的参考。在合影中,一个人的肩膀会遮住另一个人的一部分,阴影会重叠,模型不得不猜测哪些特征属于哪个人。这种猜测正是换脸的起点。
选择光线相近的肖像照。如果一位表演者被窗户光照亮,另一位被午夜的手机闪光灯照亮,这对组合仍然可以渲染,但看起来会像是合成上去的。相似的色温是你在上传前能做出的最大单项改进。
两张脸都应该清晰可见。遮住发际线的帽子、墨镜和厚重的美颜滤镜都会减少模型所需的信息。单人肖像的规则同样适用,只是要遵守两遍。
在写提示词之前先决定谁主导
每个好的双人镜头都有一个主导者。一位表演者推动交流,另一位做出反应。如果两位表演者以同样的能量做同样的事,画面就会显得平淡,模型也没有理由移动镜头。
在提示词中点明主导者:“左边的表演者向人群做手势,右边的表演者点头大笑。”这一句话就建立了一种关系。它还给模型提供了两个不同的动作去渲染,这比让两个人都做同样的表演要容易。
如果你想要真正的来回互动,就把它拆成两个片段。片段一给左边的表演者台词,片段二给右边的表演者回应。在节拍点上把它们剪接在一起。一次渲染无法承载完整的交流而不丢失其中一张脸。
能在手机屏幕上成立的走位
最安全的双人构图是并排站立,两张脸都可见,镜头位于胸部高度,缓慢推近。这不算有电影感,但它在手机尺寸下能读得清楚,并且能在片段的大部分时间里把两个身份都保持在画面中。
避免把一位表演者直接放在另一位身后。四分之三的重叠在静态画面中看起来不错,在动态中却会变成换脸生成器。避免围绕两个人快速环绕:模型必须重建它看不到的那一侧,而身体融合正是发生在这里。
如果场景需要表演者之间有距离,就明确说出来:“相距一步,面对面。”距离在有意为之的时候才有戏剧性。如果是偶然的,这对组合看起来就像陌生人在排队。
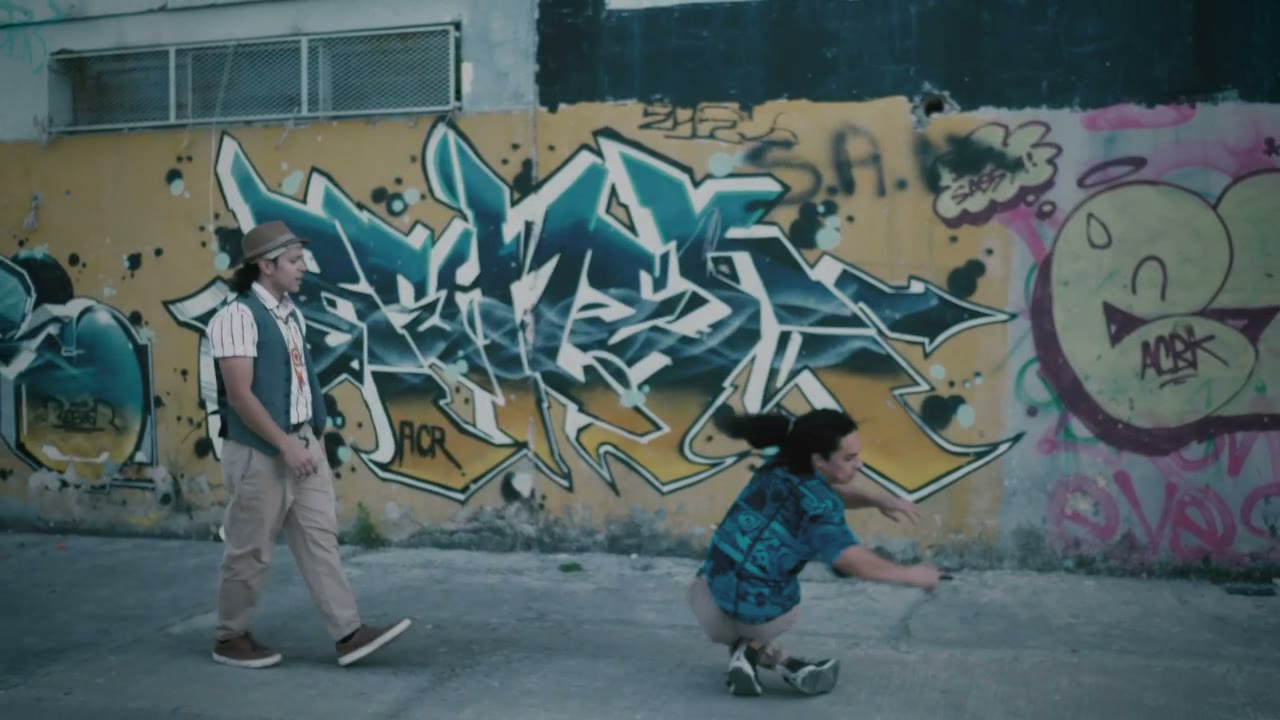
让场景匹配关系
俱乐部舞台上的双人组合读起来像一场共同表演。屋顶上的双人组合读起来像一场cypher或一个团队。复古人行道上的双人组合读起来像一段友谊、一段回忆或一次黄金时代的致敬。
选择能描述你想要的关系的场景,而不只是光线最好的那个。两位表演者在小俱乐部里轮流说唱,与两位表演者默默站在宽阔街道上,传达的东西是不同的。背景是故事的一部分。
工作室的四个预设涵盖舞台、录音棚、cypher和复古人行道。对于双人组合,Duo Stage和Retro VHS最可靠,因为两者都是围绕两个人构建的。当一位表演者明显是主导、另一位是圈子的一部分时,Night Cypher效果不错。
双人特有的失败模式
换脸。 表演者在片段中途交换了特征。原因:相似的服装、相似的头发、快速的镜头或低分辨率的照片。修复:区分服装,放慢镜头,替换较弱的照片。
肩膀融合。 这对组合变成一个剪影。原因:表演者太近,镜头太远,背景太杂乱。修复:要求留出一步的空间和更简单的背景。
第三个人。 画面边缘出现了一个额外的人影。原因:描述人群时没有限制。修复:只要求剪影,或者完全去掉人群。
一位表演者僵住。 第二个人站着不动,而主导者在表演。原因:提示词只给了一个人动作。修复:给反应者一个小的、具体的节拍——一个点头、一声大笑、一只手放在胸前。
服装漂移。 一套服装改变了颜色或形状。原因:快速运动和色彩过多相互冲突的调色板。修复:简化服装和光线。
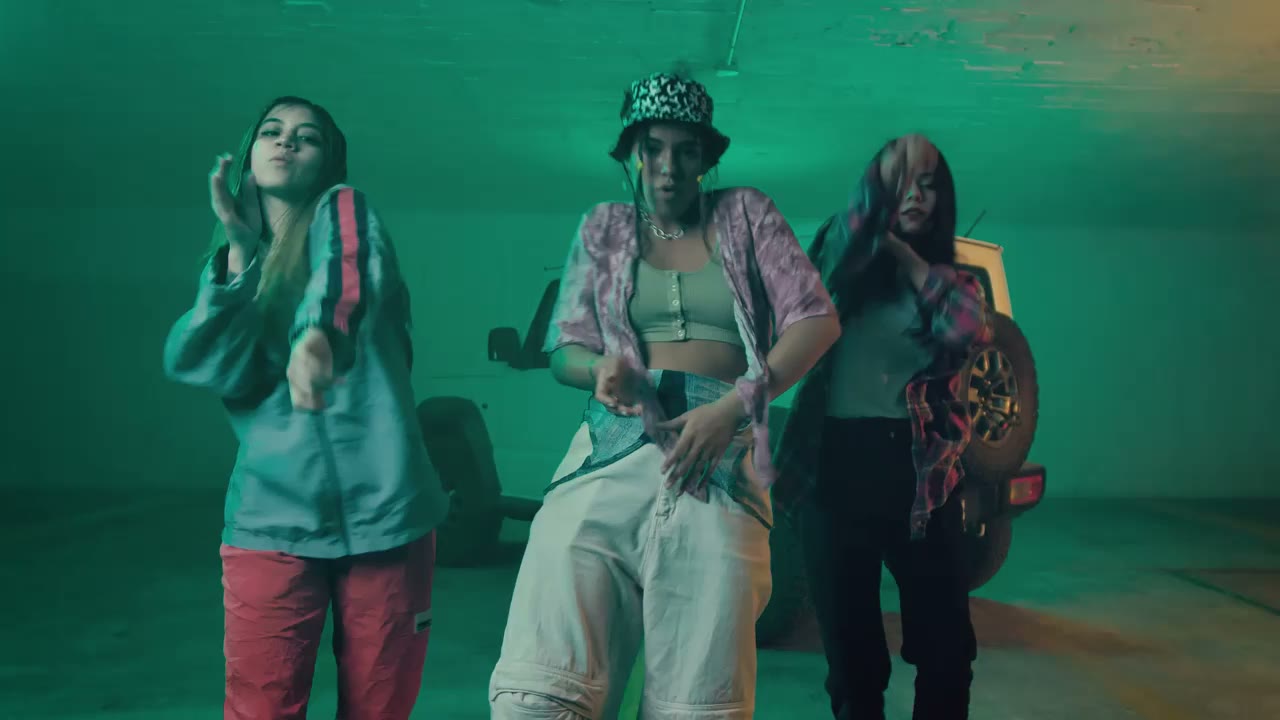
把两个片段剪成一段对话
把每位表演者作为主导分别生成一个片段,然后在小节线上在两者之间切换。这样你就能获得真正的交流,而不必要求一次渲染承担太多。在两个提示词中使用相同的地点、调色板和镜头语言,让切换感觉是连续的。
一个简单的序列:用广角双人镜头建立场景,切到左边表演者的特写,切到右边表演者的特写,再回到广角拍反应。四个切换,两个生成的片段,观众就能读出一段对话。
最后再加入音轨。表演是无声的,所以剪辑的节奏应该跟随人声,而不是反过来。如果一句歌词落在切换点上,即使底层片段很简单,剪辑也会显得是有意为之。
渲染前的简短检查清单
- 两张照片,每位表演者各一张,光线相近。
- 一个点名的主导者和一个点名的反应。
- 并排走位,两张脸都可见。
- 一个镜头运动,第一次尝试不要环绕。
- 背景足够简单,能把两个身份分开。
- 第一次测试用五到八秒。
如果这六条都成立,渲染通常就能成功。如果缺少一条,在花积分做第二次尝试之前先把它修好。
接下来读什么
AI说唱视频生成器页面介绍工作室本身。关于单人工作流程,请阅读如何制作AI说唱视频。如果你要安排的是对抗而不是合作,说唱对战视频指南里有走位说明。