照片转视频 · 文字转视频

AI 说唱视频生成器

AI 说唱视频生成器只该解决一个问题:没有摄制组、没有场地、没有灯光设备,也能把一场表演搬上屏幕。你上传表演者的照片或描述场景,选一套预设,工作室就会渲染出一段可以直接发布、提案或发给艺人的短片。

这个工作室基于 Seedance 2.0,功能刻意保持聚焦。每次渲染 5 到 12 秒,竖屏或横屏,付费输出无水印。四套预设覆盖说唱视频真正需要的镜头:舞台双人、录音棚独唱、夜间 cypher 和复古街景。

本页的视频片段均为 AI 生成的预览。它们是虚构内容,并非真实事件的记录。

更新于 2026 年 10 月 24 日

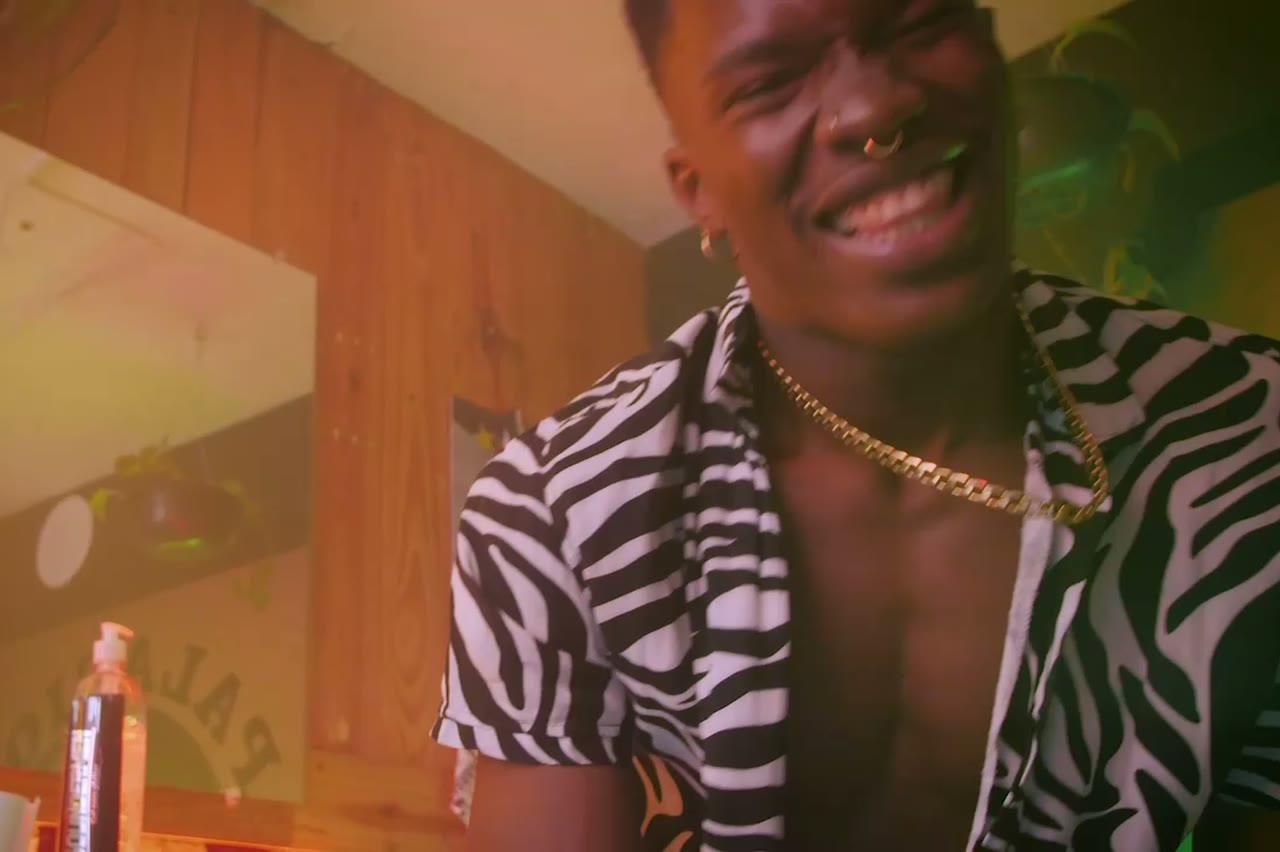
两名说唱歌手在小俱乐部紫色舞台灯光下表演,AI 说唱视频画面
时长
5–12 秒
分辨率
480p · 720p · 1080p
宽高比
9:16 · 16:9 · 1:1
水印
付费渲染无水印
模型
Seedance 2.0
内容审核
SeeAPI,失败即拦截

表演者保持可辨认

每套预设都要求模型保留照片中的面部、发型、服装、肤色和身材比例。你得到的不是一张隐约相似的陌生脸。

四个经过验证的起点

双人舞台、独唱录音棚、夜间 Cypher 和复古 VHS 都是完整提示词,不是风格标签。从预设出发改场景,而不是对着空白框发呆。

为手机屏幕而生

默认 9:16,因为 TikTok、Reels 和 Shorts 才是说唱片段传播的地方。切换 16:9 或 1:1 无需更换源照片。

工作原理

  1. 1

    添加一到两张清晰照片

    光线均匀的半身或胸像照效果最好。做双人视频时,用两张分开的照片,两张脸都清晰可见,不要加厚重滤镜。

  2. 2

    选择场景

    选一套预设或自己写提示词。说明表演者做什么、机位在哪、什么不能变。每个片段只安排一个动作和一次运镜。

  3. 3

    设置分辨率和时长

    选择 480p、720p 或 1080p,时长 5 到 12 秒,画幅 9:16、16:9 或 1:1。积分消耗在生成前显示,绝不在生成后。

  4. 4

    渲染、检查、下载

    任务在后台运行。把片段看两遍,如果出现偏移就只改一个变量,在手机尺寸下读得清楚再下载 MP4。

从经过测试的提示词开始

每条提示词都是完整的:主体、场景、镜头,以及哪些内容不能改变。复制它,或带着它预填打开工作室。

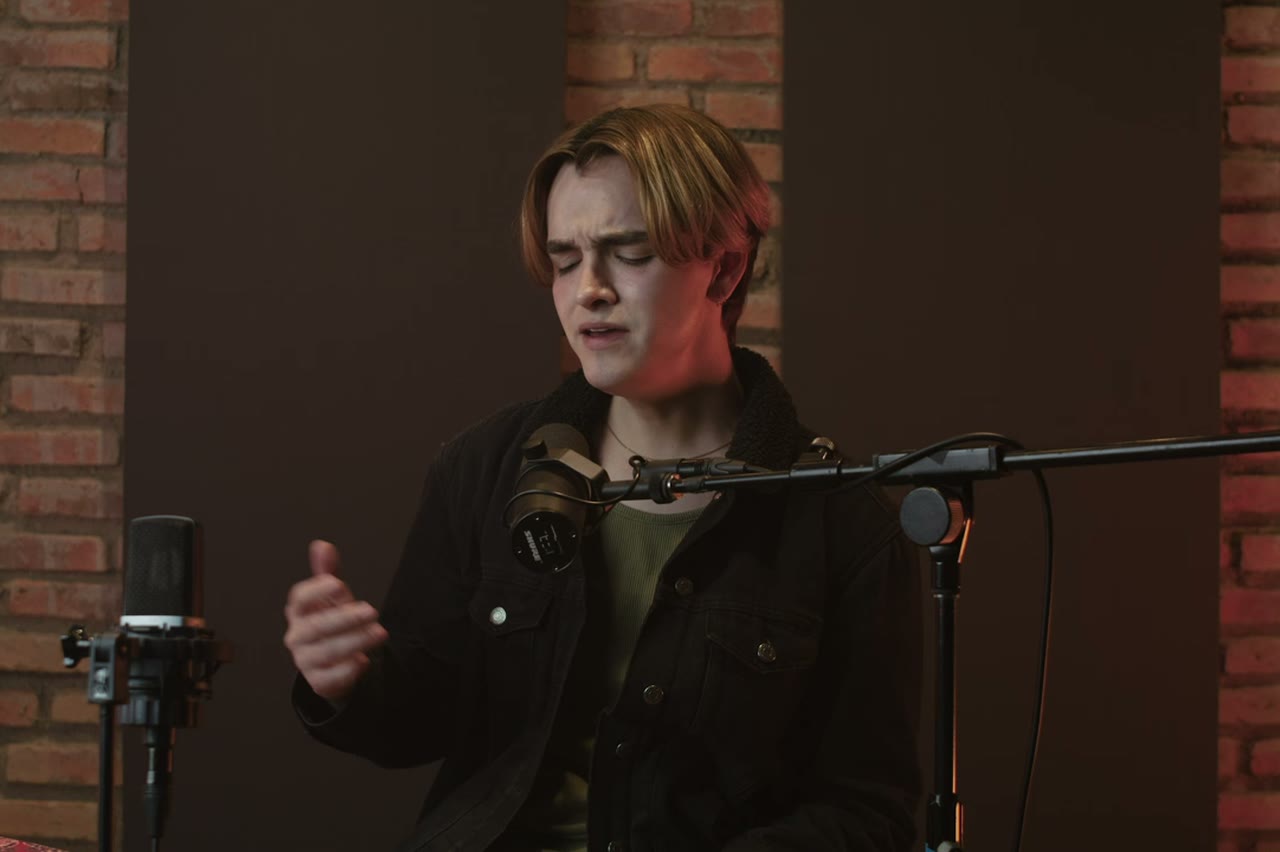
一名说唱歌手在暖色钨丝灯下对着录音棚麦克风表演,电影感 AI 片段

Duo Stage

两名说唱歌手在小俱乐部舞台上轮流说唱。

提示词(英文)

Use the two people in the uploaded photos as the only performers. A small club stage at night, purple and magenta lights cutting through haze, a packed crowd in silhouette at the front. The two rappers stand side by side trading verses, one gesturing to the crowd while the other nods to the beat. One continuous handheld shot at chest height that pushes in from the back of the stage to a tight two-shot, then drifts slightly right. Keep the faces, hair, outfits, skin tone and body proportions exactly as photographed. No lip-sync mismatch, no extra people, no text, no watermark, no logo. Vertical 9:16.

在工作室中使用

Solo Booth

近距离、私密的录音棚对镜头表演。

提示词(英文)

Use the person in the uploaded photo as the only performer. A narrow recording booth at night, a large-diaphragm condenser microphone on a shock mount, warm tungsten key light from the left and a cold blue rim light from behind. The rapper leans into the mic and performs directly to camera, shoulders moving with the beat. One slow dolly-in from a medium shot to a close-up, shallow depth of field, slight handheld float. Keep the face, hair, outfit and skin tone exactly as photographed. No headphones swapping, no extra people, no text, no watermark, no logo. Vertical 9:16.

在工作室中使用

Night Cypher

钠灯下天台上的 cypher 围圈。

提示词(英文)

Use the person in the uploaded photo as the lead performer. An empty rooftop car park at night, wet concrete reflecting orange sodium lights, a loose circle of six silhouetted figures clapping. The rapper walks into the centre of the circle and performs, turning slowly to face the camera. One continuous low-angle tracking shot that circles the performer at knee height, ending on a medium close-up. Keep the face, hair, outfit and body proportions exactly as photographed. No fighting, no extra foreground people, no text, no watermark, no logo. Vertical 9:16.

在工作室中使用

AI 说唱视频真正适合做什么

最强的用途是这周拍不出来的表演画面:艺人站在一个并不存在的拥挤俱乐部里,雨中天台上的 cypher,1990 年代街边拎着收音机的场景。它也适合预热预告、歌词帖、艺人提案或正式拍摄前的情绪板。

它不能替代完整 MV。没有音频生成,没有对人口轨的唇形同步,一次渲染里也没有多镜头剪辑。你得到的是一段短而连贯的镜头。音轨、剪辑和字幕交给你的剪辑软件。

模型能做和不能做的事

Seedance 2.0 擅长灯光、布料、运镜和短段编排动作。它在文字、手部特写、复杂道具和精确唇形同步上较弱。所以每套预设都避开可读招牌,让手握着麦克风或做手势,拍表演而不是对白。

相似度是参考,不是扫描。正面、清晰、眼睛锐利、面部无遮挡的照片能给模型最多信息。墨镜、头发遮脸和厚重美颜滤镜都会让结果偏移。如果脸不对,解决办法通常是换更好的照片,而不是写更长的提示词。

经得起第二次渲染的工作流

改提示词之前,先用同一张照片跑两套不同预设。在手机尺寸下比较,而不是全屏。能在信息流里读清楚的片段才值得保留,哪怕大图里手有点糊、麦克风架有点弯。

出问题时,一次只改一个变量:运镜、动作或场景。重写整段提示词会让你分不清是哪处改动起了作用。为你喜欢的每个片段记下提示词、照片和设置;这份记录就是可复用视觉风格的起点。

常见问题

生成说唱视频需要照片吗?

不需要。概念场景可以用文字转视频,但照片能给你一个可辨认的表演者。多数人从一张清晰肖像加一套预设开始。

工作室会生成歌曲或人声吗?

不会。它只生成画面。用你自己的音轨、授权伴奏或语音备忘,然后在剪辑软件里加上音频。

脸会和照片完全一致吗?

照片清晰、正面、光线均匀时,相似度会很高。墨镜、厚重滤镜、遮挡面部或分辨率过低都会让结果偏移。把它当作高度相似,而不是法医级比对。

单个片段能多长?

5 到 12 秒。更长的视频靠剪辑多个片段拼成,这也给了你变换机位的理由。

片段可以商用吗?

你拥有自己生成的输出,但受模型提供商条款和你对上传照片的权利约束。不要上传未经本人同意出镜的照片。

有水印吗?

付费渲染下载无水印。工作室内的预览会带标记,以免被误认为最终文件。

一个片段要多少积分?

价格以积分计,取决于分辨率和时长。确切消耗在点击生成前显示;当前方案见定价页。

把你的照片变成视频片段

从本页的预设开始,或自己写一个镜头。生成前会显示所需积分,渲染失败会退还积分。