酒店大堂AI趋势:橙色亭子片段解析
 AI Rap Video Team
酒店大堂AI趋势为何席卷信息流,橙色亭子格式从何而来,以及如何在不借用他人面孔的情况下制作你自己的双照片片段。
每隔几个月,就会有一种视觉格式从音乐视频中脱离出来,成为一套模板。2026 年末,这个角色由橙色电话亭担当:一面高饱和度的墙,一支从天花板垂下的麦克风,两个人在一个固定镜头里轮流说唱。搜索热度在几天内随之而来,一批模仿网站也应运而生。
本指南将说明 Hotel Lobby AI 趋势究竟是什么、为什么这种格式如此适合生成式视频,以及如何做出一段经得起看的片段——包括大多数趋势页面略去的那部分:同意。
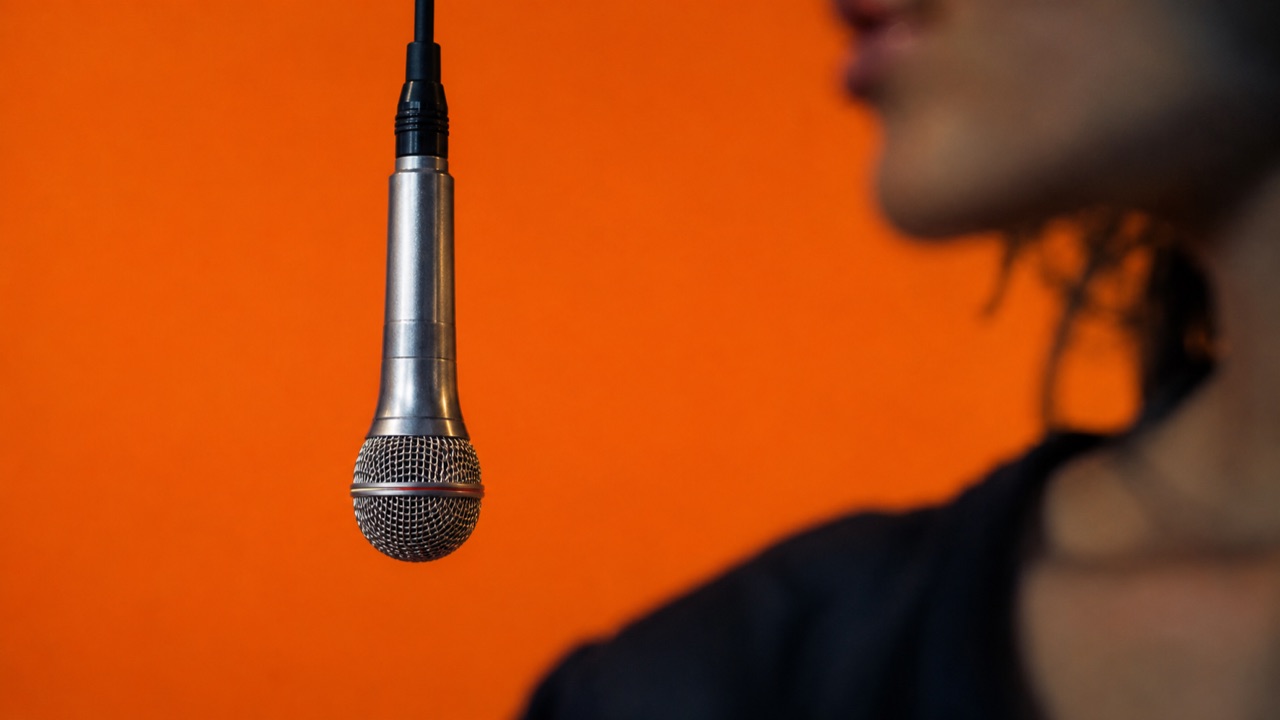
Hotel Lobby 的视觉是什么样的
把歌曲剥离之后,这种格式就是四个决定:
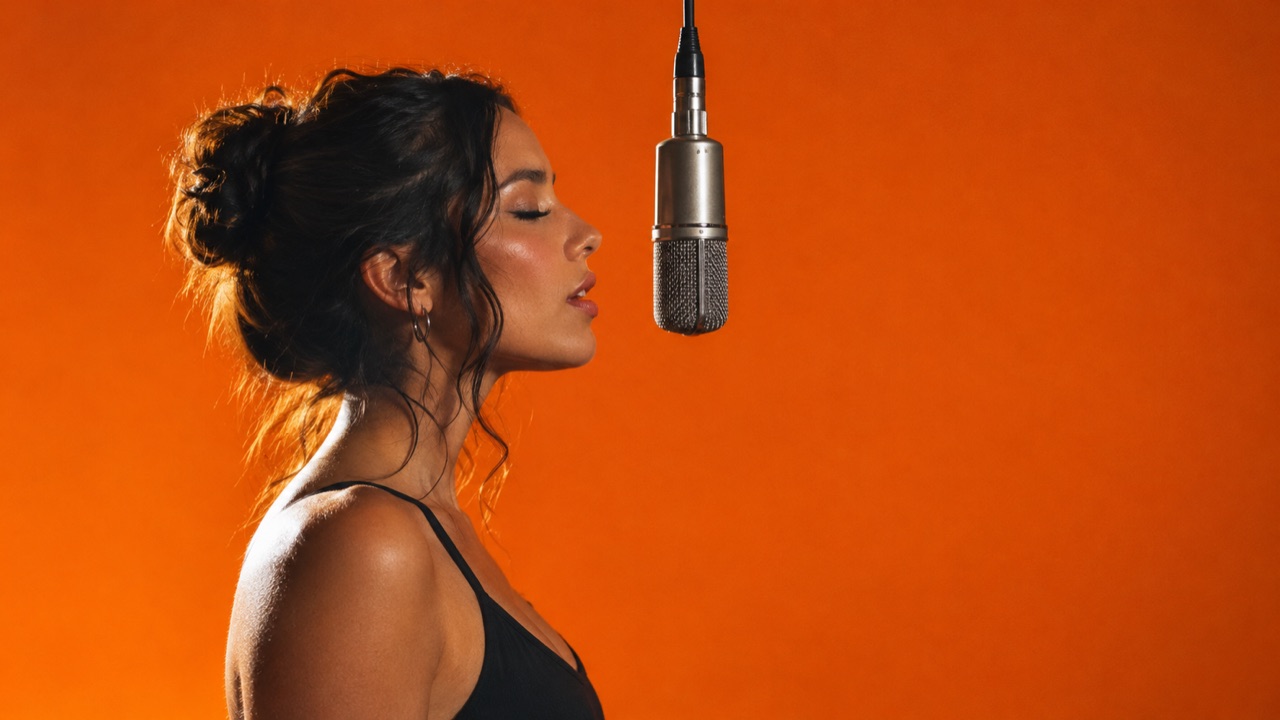
- 一个背景。 一面无缝、高饱和度的橙色墙,没有任何布景。
- 一个道具。 一支从上方垂下的麦克风,大致在头部高度。
- 两位表演者。 他们站在麦克风前轮流说唱,一人主导,另一人做出反应。
- 一个机位。 一个固定的中景双人镜头,胸部高度,最多缓慢推近。不剪辑。
这就是全部的语法。它更接近一次肖像拍摄,而不是一支音乐视频,这也是为什么它即使在信息流三秒钟的滑动中也能被瞬间读懂。
参照点是 2022 年 COLORS 现场演出中 Quavo 和 Takeoff 表演的《Hotel Lobby》。橙色电话亭、悬挂的麦克风和双人镜头的调度都来自那场演出。当人们搜索“Hotel Lobby AI”或“Migos AI”时,他们描述的是这种视觉,而不是在寻找某位特定的艺人。
为什么这种格式如此适合 AI 视频
大多数 AI 视频提示词失败,是因为它们要求太多:人群、镜头运动、服装更换,还要在五秒钟内讲一个故事节拍。模型必须把这一切都凭空创造出来,于是接缝就露出来了。
橙色电话亭几乎移除了所有变量。只有一盏灯、一个背景、两个人、一个机位。模型的任务缩减为三件事:保持两张脸稳定,保持身体合理,让表演读得出来。这恰好是当前视频模型最擅长处理的一组问题。
它还移除了 AI 视频中最难的问题,即跨剪辑的连续性。一个固定的单镜头没有任何需要匹配的东西。片段在同一帧开始和结束,所以观众永远看不到模型的弱点。
还有第三个原因,而且是商业性的:这种格式天生就是竖屏的。两个人在胸部高度,正好放进 9:16 的画幅,还留有字幕空间。它诞生于现场演出,却以短视频的形式传播。
从现场演出到搜索词
如果你正在决定是为这个趋势做产品还是等它过去,时间线很重要。
- 2022 年。 原版演出播出。橙色电话亭成为说唱中一个可识别的图像。
- 2026 年 9 月中旬。 AI 版本开始流传。这种格式很容易写提示词,所以它迅速传遍短视频信息流。
- 2026 年 9 月底至 10 月初。 精确匹配域名出现。9 月 27 日至 10 月 3 日之间至少注册了九个
rapduo.*域名,外加一批airapvideo.*、airapvid.*和rapvideo.*名称。大多数只是同一个模型外面的薄薄一层包装。 - 2026 年 10 月。 “hotel lobby ai”的 Google 自动补全填出 free、video、trend、generator 和 template。“Migos ai”填出 trend、video generator、song 和 meme。这个查询已经从一种格式变成了一个产品搜索。
当一个查询有稳定的视觉答案时,趋势页面就值得做。这个查询就有:人们在到达之前就已经知道片段应该长什么样。页面的任务是让他们做出一个,而不是解释他们想要什么。
大多数趋势页面跳过的那部分:同意
这种格式底下有一个真实的问题,假装它不存在正是网站被下架的原因。
这个趋势让一位 2022 年遇害艺人的表演重新浮出水面。许多流传的片段把真实的面孔——艺人、名人、从社交媒体上拉来的陌生人——放进一个他们从未同意参与的场景。这不是造型选择。这是肖像权问题,在某些司法管辖区还是法律问题。
AI Rap Video 的立场很简单:
- 上传你自己的照片,或已同意的人的照片。 不是公众人物,不是前任,不是同学。
- 不做声音克隆。 工作室生成画面,不生成人声。
- 不使用真实录音。 原歌曲中的任何内容都不会被使用。
- 无关联。 这是一个独立工具。它与 Migos、任何艺人、任何厂牌或 COLORS 系列均无关联。
- 发布时标注合成媒体。 大多数平台现在都要求这样做。
用两张已同意的面孔做出的虚构表演是一种创作行为。用别人的照片做出的同一个片段则是一个迟早会爆发的问题。界线就是这么简单,一个不说明这一点的工具并不是在帮它的用户。
用四个决定做出你自己的片段
1. 两张照片
每张照片一个人,面部无遮挡,光线相近。一张在窗边拍的正面肖像,每次都胜过一张戏剧性的低角度照片,因为模型需要看到整张脸才能保持稳定。
避免太阳镜、重度滤镜、遮住发际线的帽子和合影。如果两人将穿非常不同的服装,请在提示词中说明——相似的服装是两位表演者之间换脸的最常见原因。
2. 调度
决定谁主导。如果两个人都以同样的能量做同样的事,看起来会很僵。给主导者动作,给第二位表演者一个反应:点头、大笑、把手放在胸口。
让他们并排站在麦克风前。四分之三的重叠在静止画面里好看,在运动中会变成肩膀融合。
3. 提示词
粘贴这段,然后修改服装和反应:
Use the two people in the uploaded photos as the only performers. A saturated
orange seamless backdrop with a single silver microphone hanging from the
ceiling between them. The two rappers stand at the microphone trading verses,
one gesturing while the other nods, both facing the camera. Static medium
two-shot at chest height with a very slow push-in. Keep the faces, hair,
outfits, skin tone and body proportions exactly as photographed. No text, no
watermark, no logo, no real person likeness, no extra people.
结尾的否定句不是装饰。“No text, no watermark, no logo, no real person likeness”正是防止渲染凭空造出一个衬衫标志、或让一张脸漂向某位名人的原因。
4. 时长
五秒是一个钩子。十二秒是一个场景。如果你打算卡着节拍剪辑,渲染十二秒再裁剪:当那句歌词比你预期更早落下时,你会需要那些多出来的帧。
配乐:片段按设计是无声的
工作室返回的是无声视频。这不是需要绕过的限制;这正是片段有用的原因。你的音轨保持原样,你跟着音乐剪画面,而不是去找一首与生成的节拍匹配的歌。
使用你有权使用的音频。剪掉头尾,把循环点放在节拍上,并保持第一帧可读,这样片段在信息流中被裁切后仍能存活。一段十二秒的片段配在八小节循环上,读起来就是一个完整的场景。
值得尝试的变体
一旦基本的双人镜头奏效,一次只改变一个变量:
- 单人电话亭。 一位表演者,同样的橙色墙,同样的悬挂麦克风。适合一段不需要第二个人的说唱。
- 团队画面。 保留双人,在底边加一排失焦的剪影。人群读起来是能量,而不会抢走焦点。
- 换色。 这种格式经得起背景更换:深红、钴蓝,或纸白色的天幕。保持单一光源和悬挂的麦克风,构图依然成立。
- 宠物双人组。 两只宠物,一支麦克风。这种格式荒诞到足以当笑话成立,而构图规则完全相同。
如何区分趋势页面和模板农场
“hotel lobby ai”的搜索结果已经挤满了在过去三周内注册的页面。几个信号可以把工具和落地页区分开来:
- 一个你能读到的提示词。 如果页面展示了实际的提示词,说明运营者用过自己的产品。
- 诚实的音频声明。 如果它承诺生成歌曲和生成人声,检查文件里实际有什么。
- 一行同意声明。 在上传表单附近找它,而不是埋在条款里。
- 以积分和货币标示的透明定价。 需要绑卡的“免费”不是免费。
- 渲染失败时的退款规则。 生成会失败;问题是谁来承担。
AI Rap Video 用一到两张照片渲染一段无声表演片段,时长 5 到 12 秒,分辨率 720p 或 1080p。默认的 12 秒 720p 片段花费 35 积分,失败的渲染会退款,且没有水印。如果你想要这种格式本身,请从 Hotel Lobby AI 视频页面开始。如果两位表演者才是重点,说唱双人视频指南更深入地讲解了走位和身份一致性。
趋势会继续向前。这项技能——两张干净的照片、一个清晰的主导者、一个镜头运动、你自己的音轨——会在接下来出现的任何背景上继续奏效。