Seedance 2.0 per i video rap: cosa fa bene
 AI Rap Video Team
Uno sguardo pratico a Seedance 2.0 per i clip di performance rap: movimento, somiglianza, illuminazione, testo e i tipi di inquadratura che gestisce meglio, con limiti onesti.
Seedance 2.0 è il modello video alla base di questo studio. È bravo con inquadrature di performance brevi e cinematografiche: tessuto che si muove con un corpo, luce colorata che taglia la foschia, una camera che avanza senza perdere il soggetto. Non è un motore per videoclip musicali. Sapere quale metà di questa frase si applica alla tua idea fa risparmiare crediti.
Questa guida riguarda il comportamento del modello nelle inquadrature specifiche del rap. Non è un benchmark e non è affiliata al produttore del modello. Tutto ciò che segue deriva dai tipi di inquadratura che questo studio espone e dalle modalità di errore che quelle inquadrature producono.
In cosa il modello è bravo
Luce e atmosfera. Le luci pratiche colorate, la foschia, la luce di contorno e le superfici bagnate vengono rese in modo convincente. Un palco da club o un tetto di notte dà al modello abbastanza informazioni visive per costruire una stanza credibile.
Tessuto e silhouette. Felpe con cappuccio, giacche e abiti larghi si muovono con il corpo. Questo conta nelle immagini rap, dove la silhouette spesso porta tanta attitudine quanto il volto.
Un singolo movimento di camera. Un push-in, un carrello laterale o un'orbita lenta funzionano quando il soggetto resta nell'inquadratura. Il movimento è abbastanza fluido da sembrare diretto anziché generato.
Brevi beat di performance. Un cenno del capo, un gesto, un passo verso la camera, un voltarsi verso l'obiettivo. Questi si leggono in modo pulito in cinque-dodici secondi, che è esattamente il formato che lo studio vende.
In cosa è debole
Testo. Insegne, etichette, tatuaggi con scritte e testi a schermo si degradano tutti. Il modello può produrre qualcosa che sembra testo da lontano e si trasforma in nonsenso da vicino. Ogni preset esclude il testo leggibile per questo motivo.
Mani in primo piano. Le dita sono il guasto più comune. Tieni le mani su un microfono, in tasca o in movimento abbastanza rapido che lo spettatore non le studi.
Sincronizzazione labiale precisa. Il modello non riceve il tuo stem vocale e non può sincronizzarsi con esso. Una clip di performance sembra una performance; non sembra doppiata. Aggiungi la traccia in un editor e taglia intorno al disallineamento.
Continuità multi-inquadratura. Un render è un'inquadratura. Chiedere un taglio, un cambio di location e un cambio di guardaroba nella stessa clip produce una poltiglia. Genera inquadrature separate e montale.
Persone reali e identificabili. Le richieste che coinvolgono celebrità o figure pubbliche vengono rifiutate, e usare le sembianze di una persona reale senza consenso non è consentito. Carica solo persone che hanno accettato di apparire.
I tipi di inquadratura adatti al modello
I preset sono scelti intorno ai punti di forza del modello, non intorno a una lista arbitraria di cliché da videoclip musicale:
- Due persone in club. Due performer, una folla in silhouette, un push-in a mano. Lo sfondo è affollato ma i volti sono grandi.
- Primo piano in cabina. Un performer, un microfono, chiave calda e controluce freddo. Il test di identità più semplice e l'inquadratura più affidabile.
- Cypher sul tetto. Un lead, un cerchio di silhouette, luce al sodio su cemento bagnato. Abbastanza world-building senza chiedere i volti individuali della folla.
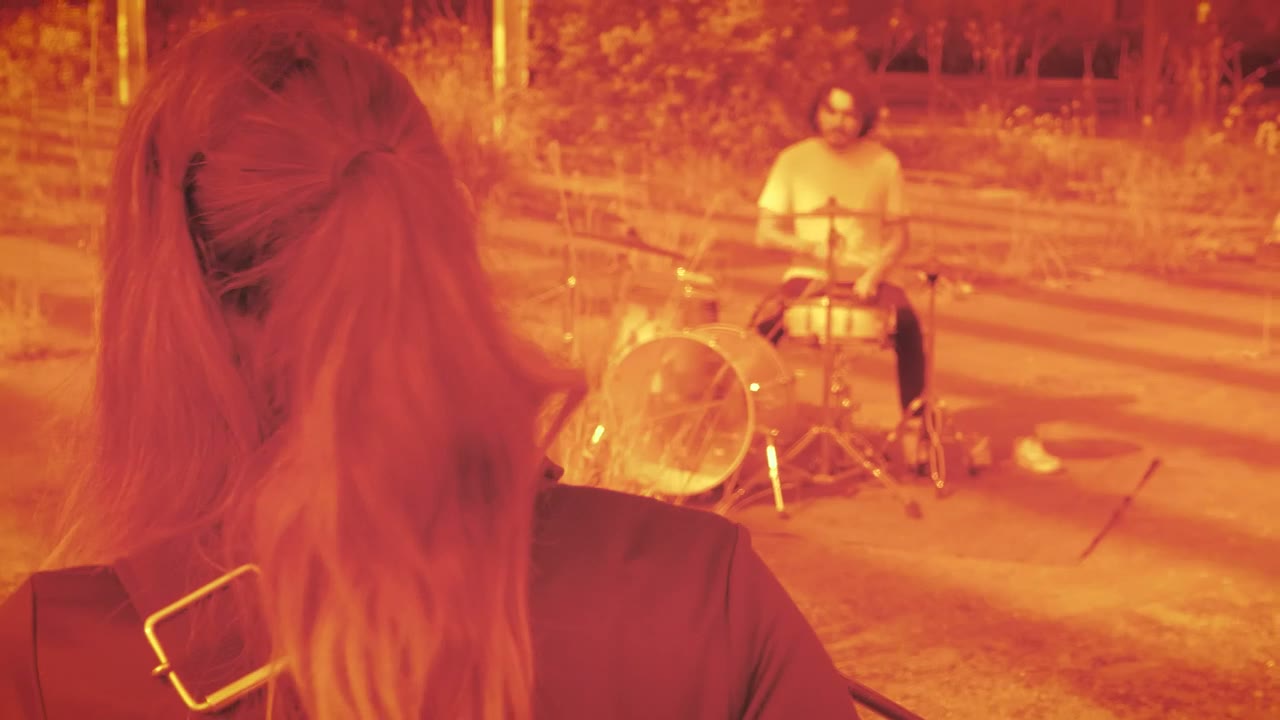
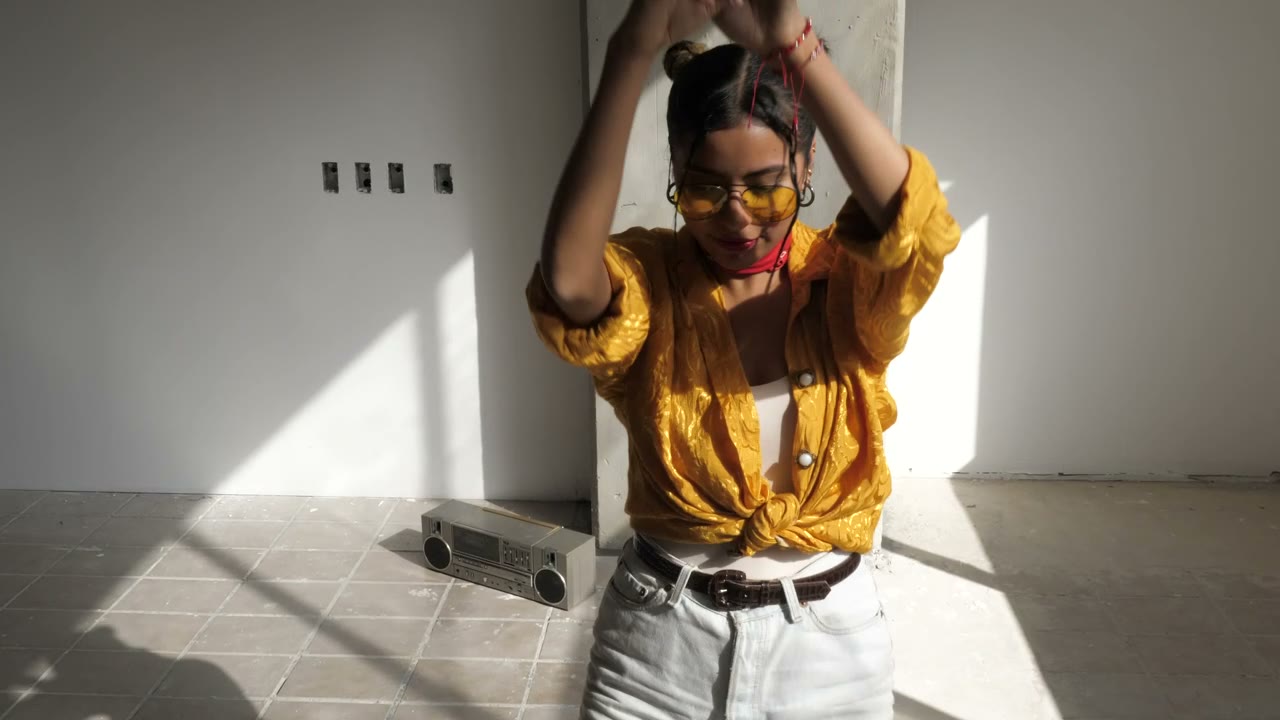
- Marciapiede retrò. Due performer, un boombox, grana calda da pellicola. Il dettaglio d'epoca è limitato agli oggetti che il modello può tenere: mattoni, abbigliamento, un boombox.
Ognuno mantiene basso il numero di parti in movimento. Questo è il principio di progettazione: meno oggetti, meno identità, un movimento di camera.
Scrivere prompt per il modello, non contro di esso
Scrivi l'inquadratura nell'ordine in cui il modello la pesa: soggetto, luogo, luce, camera, vincoli. Metti l'istruzione sull'identità all'inizio e ripetila alla fine. Usa un linguaggio fisico semplice — "chiave tungsteno calda da sinistra", "lento dolly-in", "altezza petto" — anziché etichette estetiche.
Evita prompt solo negativi. "Niente sfocatura, niente distorsione" non dice al modello cosa renderizzare. Di' cosa c'è, poi di' cosa non deve apparire. I preset fanno entrambe le cose.
Tieni la clip breve quando stai testando. Un render di cinque secondi a 720p è il modo più economico per scoprire se una foto e una scena funzionano insieme. Una volta che l'identità tiene, ri-renderizza il vincitore più a lungo e a una risoluzione più alta.
Sembianze: cosa aspettarsi
Il modello usa la tua foto come riferimento, non come scansione. Un ritratto nitido e frontale produce una somiglianza forte. Una foto morbida, un volto coperto o un filtro pesante producono deriva, e nessuna quantità di testo nel prompt sistema un'immagine sorgente che ha già perso l'informazione.
Il miglioramento più affidabile è una foto migliore: luce uniforme, occhi visibili, attaccatura dei capelli visibile, espressione neutra. Il secondo più affidabile è un movimento di camera più lento. Il terzo è una scena più semplice. La formulazione del prompt è quarto.
Costo e durata in pratica
Lo studio applica prezzi per risoluzione e durata, e mostra il costo prima che il task venga inviato. Una clip standard di dodici secondi a 720p è l'unità di riferimento nella pagina dei prezzi. Le clip più brevi costano meno; il 1080p costa di più. Non c'è un piano gratuito, quindi l'anteprima e il prezzo fanno parte della stessa decisione.
La maggior parte delle clip termina in un paio di minuti. Un render a 1080p può richiedere più tempo. Puoi lasciare la pagina e tornare; il task è memorizzato sul tuo account.
Cosa codificano i preset
Ogni preset dello studio è un prompt completo, non un filtro. Duo Stage codifica due performer, un club, foschia, luci pratiche magenta e un push-in a mano. Solo Booth codifica un performer, un microfono, chiave calda e controluce freddo, e un lento dolly. Night Cypher codifica un lead, un cerchio di silhouette e luce al sodio su cemento bagnato. Retro VHS codifica due performer, un boombox, grana calda e un leggero alone.
Leggili come esempi svolti. La struttura è coerente: soggetto, luogo, luce, camera, vincoli. Una volta che vedi quel pattern, puoi scrivere un quinto preset senza indovinare a quali parole il modello risponde.
I prompt mostrano anche cosa non viene chiesto al modello di fare. Nessuno di loro chiede un taglio, un testo, un logo o un primo piano sincronizzato labialmente. Quelle omissioni sono deliberate, ed è per questo che i preset renderizzano in modo affidabile.
Quando usare uno strumento diverso
Se hai bisogno di una performance sincronizzata labialmente su un vocale finito, questo è lo strumento sbagliato. Se hai bisogno di un visualizer di dieci minuti, genera un loop e ripetilo in un editor. Se hai bisogno di un prodotto reale, un locale reale o una folla reale, riprendili. Seedance è più forte quando il mondo può essere inventato e il performer è l'unica cosa reale nell'inquadratura.
Per il flusso di lavoro intorno al modello, leggi come fare un video rap con l'AI. Per i prompt, usa la libreria di 12 prompt.
Guide correlate
Come creare un video rap con l'IA da una sola foto (guida 2026)
Il flusso di lavoro esatto per trasformare un ritratto in una clip di performance rap: scegli la foto, seleziona una scena, scrivi un'azione, esegui il rendering, rivedi ed esporta.
Guida al video rap in duo con l'AI: due volti, una scena
Come generare un video rap in duo convincente da due foto: luce coerente, posizionamento, chi guida, come evitare scambi di volto e come montare il risultato.
Tendenza AI Hotel Lobby: il clip della cabina arancione, spiegato
Perché la tendenza AI Hotel Lobby ha invaso i feed, da dove arriva il formato della cabina arancione e come creare il tuo clip con due foto senza usare il volto di qualcun altro.