Seedance 2.0 para vídeos de rap: o que ele faz bem
 AI Rap Video Team
Uma análise prática do Seedance 2.0 para clipes de performance de rap: movimento, semelhança, iluminação, texto e os tipos de plano que ele lida melhor, com limites honestos.
O Seedance 2.0 é o modelo de vídeo por trás deste estúdio. Ele é bom em planos curtos e cinematográficos de performance: tecido se movendo com um corpo, luz colorida cortando a névoa, uma câmera que avança sem perder o sujeito. Ele não é um motor de videoclipe. Saber qual metade dessa frase se aplica à sua ideia economiza créditos.
Este guia trata do comportamento do modelo em planos específicos de rap. Não é um benchmark e não é afiliado ao criador do modelo. Tudo abaixo vem dos tipos de plano que este estúdio expõe e dos modos de falha que esses planos produzem.
No que o modelo é bom
Luz e atmosfera. Luzes práticas coloridas, névoa, luz de contorno e superfícies molhadas são renderizadas de forma convincente. Um palco de clube ou um terraço à noite dá ao modelo informação visual suficiente para construir um ambiente verossímil.
Tecido e silhueta. Moletons, jaquetas e roupas soltas se movem com o corpo. Isso importa em visuais de rap, onde a silhueta muitas vezes carrega tanta atitude quanto o rosto.
Um único movimento de câmera. Um avanço, um travelling lateral ou uma órbita lenta funcionam quando o sujeito permanece no enquadramento. O movimento é suave o bastante para parecer dirigido, e não gerado.
Batidas curtas de performance. Um aceno de cabeça, um gesto, um passo em direção à câmera, uma virada para a lente. Esses elementos são lidos com clareza em cinco a doze segundos, que é exatamente o formato que o estúdio vende.
No que ele é fraco
Texto. Placas, etiquetas, tatuagens com letras e letras na tela se degradam. O modelo pode produzir algo que parece texto de longe e vira bobagem de perto. Todo preset exclui texto legível por esse motivo.
Mãos em close-up. Os dedos são a falha mais comum. Mantenha as mãos em um microfone, no bolso ou se movendo rápido o suficiente para que o espectador não as estude.
Sincronia labial precisa. O modelo não recebe sua faixa vocal e não consegue sincronizar com ela. Um clipe de performance parece performance; não parece dublado. Adicione a faixa em um editor e corte em torno da incompatibilidade.
Continuidade entre múltiplos planos. Uma renderização é um plano. Pedir um corte, uma mudança de locação e uma mudança de figurino no mesmo clipe produz uma papa. Gere planos separados e edite-os.
Pessoas reais e identificáveis. Pedidos envolvendo celebridades ou figuras públicas são recusados, e usar a semelhança de uma pessoa real sem consentimento não é permitido. Envie apenas pessoas que concordaram em aparecer.
Os tipos de plano que se encaixam no modelo
Os presets são escolhidos em torno dos pontos fortes do modelo, não em torno de uma lista arbitrária de clichês de videoclipe:
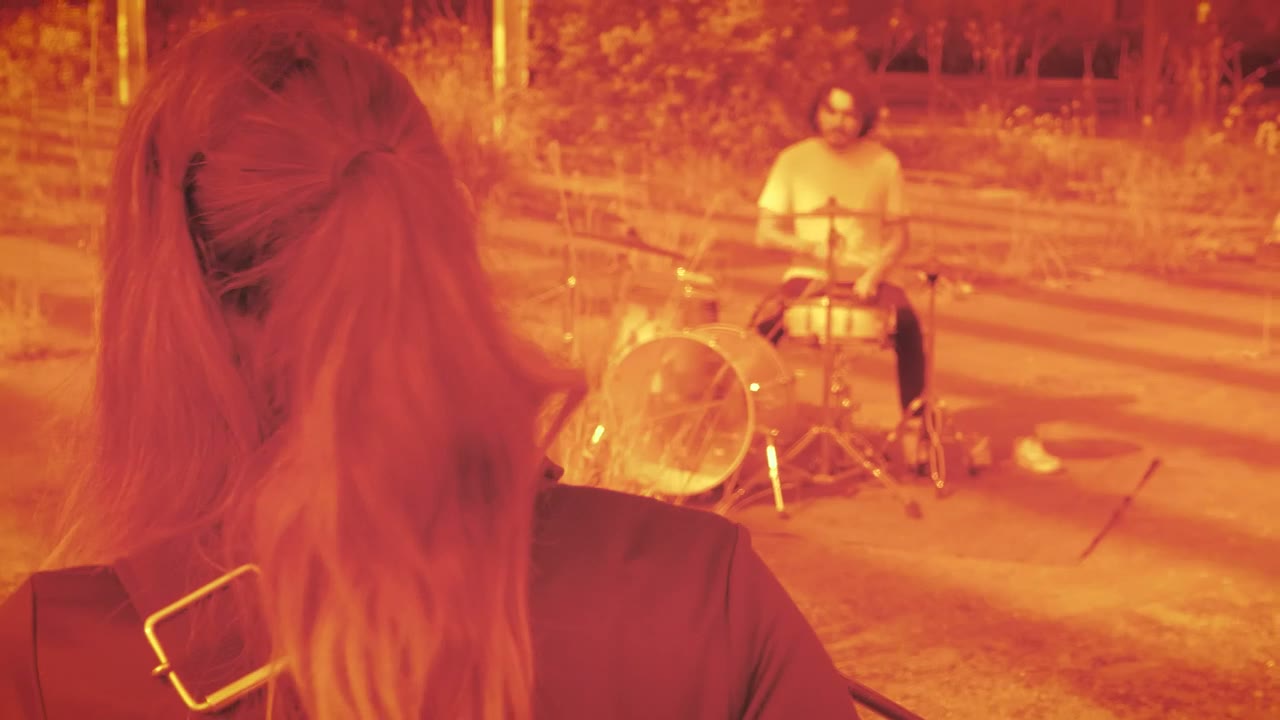
- Plano duplo de clube. Dois performers, uma multidão em silhueta, um avanço de câmera na mão. O fundo é movimentado, mas os rostos são grandes.
- Close-up de cabine. Um performer, um microfone, luz principal quente e contorno frio. O teste de identidade mais simples e o plano mais confiável.
- Cypher no terraço. Um líder, um círculo de silhuetas, luz de sódio em concreto molhado. Construção de mundo suficiente sem pedir rostos individuais da multidão.
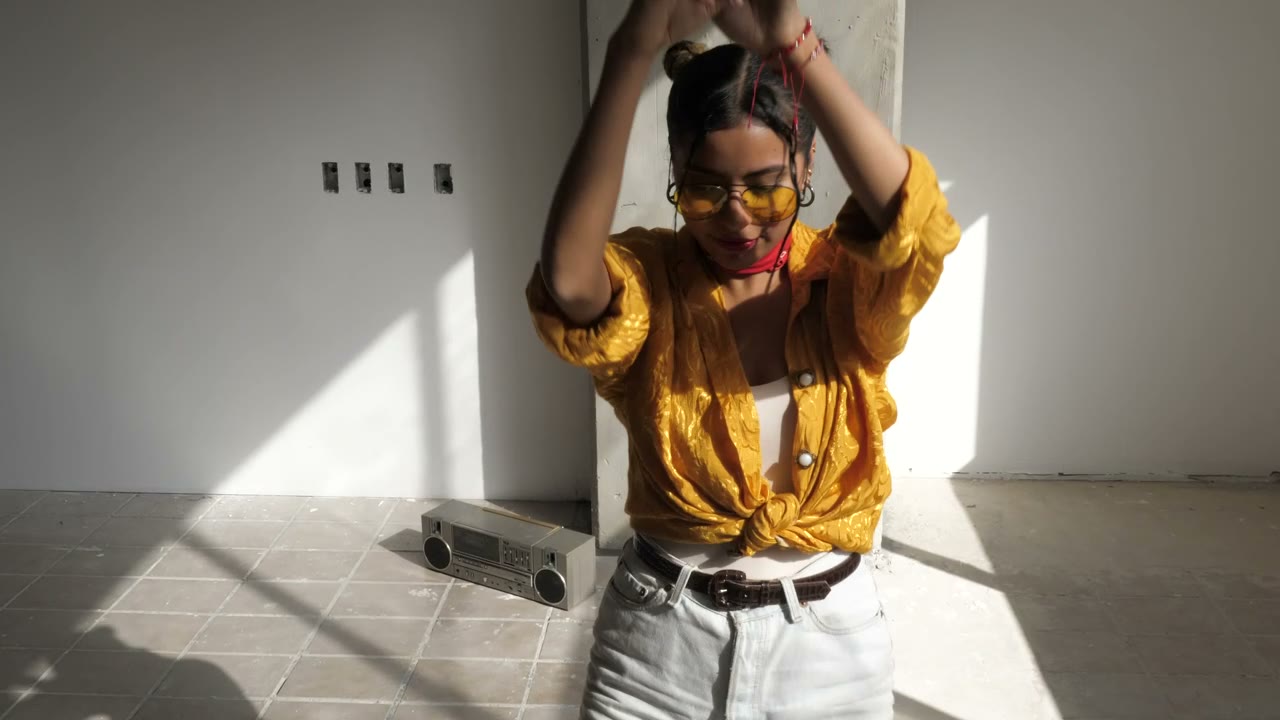
- Calçada retrô. Dois performers, um boombox, granulação de filme quente. O detalhe de época é limitado a objetos que o modelo consegue segurar: tijolo, roupa, um boombox.
Cada um mantém baixo o número de partes móveis. Esse é o princípio de design: menos objetos, menos identidades, um movimento de câmera.
Escrever prompts a favor do modelo, não contra ele
Escreva o plano na ordem em que o modelo o pondera: sujeito, lugar, luz, câmera, restrições. Coloque a instrução de identidade cedo e repita-a no final. Use linguagem física simples — "luz principal tungstênio quente vinda da esquerda", "dolly-in lento", "altura do peito" — em vez de rótulos estéticos.
Evite prompts apenas negativos. "Sem desfoque, sem distorção" não diz ao modelo o que renderizar. Diga o que está lá, depois diga o que não deve aparecer. Os presets fazem as duas coisas.
Mantenha o clipe curto quando estiver testando. Uma renderização de cinco segundos em 720p é a maneira mais barata de descobrir se uma foto e uma cena funcionam juntas. Depois que a identidade se mantiver, renderize novamente o vencedor por mais tempo e em resolução mais alta.
Semelhança: o que esperar
O modelo usa sua foto como referência, não como escaneamento. Um retrato nítido e de frente produz uma semelhança forte. Uma foto suave, um rosto coberto ou um filtro pesado produzem desvio, e nenhuma quantidade de texto no prompt corrige uma imagem de origem que já perdeu a informação.
A melhoria mais confiável é uma foto melhor: luz uniforme, olhos visíveis, linha do cabelo visível, expressão neutra. A segunda mais confiável é um movimento de câmera mais lento. A terceira é uma cena mais simples. A redação do prompt é a quarta.
Custo e duração na prática
O estúdio cobra por resolução e duração, e mostra o custo antes de a tarefa ser enviada. Um clipe padrão de 720p com doze segundos é a unidade de referência na página de preços. Clipes mais curtos custam menos; 1080p custa mais. Não há nível gratuito, então a prévia e o preço fazem parte da mesma decisão.
A maioria dos clipes termina em alguns minutos. Uma renderização em 1080p pode levar mais tempo. Você pode sair da página e voltar; a tarefa fica armazenada na sua conta.
O que os presets codificam
Cada preset do estúdio é um prompt completo, não um filtro. O Duo Stage codifica dois performers, um clube, névoa, luzes práticas magenta e um avanço de câmera na mão. O Solo Booth codifica um performer, um microfone, luz principal quente e contorno frio, e um dolly lento. O Night Cypher codifica um líder, um círculo de silhuetas e luz de sódio em concreto molhado. O Retro VHS codifica dois performers, um boombox, granulação quente e um leve halation.
Leia-os como exemplos resolvidos. A estrutura é consistente: sujeito, lugar, luz, câmera, restrições. Depois que você enxerga esse padrão, consegue escrever um quinto preset sem adivinhar a quais palavras o modelo responde.
Os prompts também mostram o que não se pede ao modelo. Nenhum deles pede um corte, uma letra, um logotipo ou um close-up com sincronia labial. Essas omissões são deliberadas, e são o motivo pelo qual os presets renderizam de forma confiável.
Quando usar uma ferramenta diferente
Se você precisa de uma performance com sincronia labial para um vocal finalizado, esta é a ferramenta errada. Se você precisa de um visualizer de dez minutos, gere um loop e repita-o em um editor. Se você precisa de um produto real, um local real ou uma multidão real, filme. O Seedance é mais forte quando o mundo pode ser inventado e o performer é a única coisa real no enquadramento.
Para o fluxo de trabalho em torno do modelo, leia como fazer um videoclipe de rap com IA. Para prompts, use a biblioteca de 12 prompts.
Guias relacionados
Como fazer um vídeo de rap com IA a partir de uma foto (guia 2026)
O fluxo de trabalho exato para transformar um retrato em um clipe de rap: escolha a foto, selecione uma cena, escreva uma ação, renderize, revise e exporte.
Guia de vídeo de dupla de rap com IA: duas caras, uma cena
Como gerar um vídeo convincente de dupla de rap a partir de duas fotos: luz combinando, posicionamento, quem lidera, como evitar trocas de rosto e como cortar o resultado.
12 prompts de vídeo de rap com IA que realmente funcionam
Doze prompts prontos para copiar e colar em clipes de performance de rap: palco de clube, cabine, cypher, calçada retrô, laje de drill, base de lyric e mais, com as proteções que mantêm os rostos estáveis.