Seedance 2.0 para videos de rap: en qué destaca
 AI Rap Video Team
Una mirada práctica a Seedance 2.0 para clips de rap: movimiento, parecido, iluminación, texto y los tipos de plano que mejor maneja, con límites honestos.
Seedance 2.0 es el modelo de video que hay detrás de este estudio. Es bueno en tomas de interpretación cortas y cinematográficas: tela que se mueve con un cuerpo, luz de color que atraviesa la neblina, una cámara que avanza sin perder al sujeto. No es un motor de videos musicales. Saber cuál de las dos mitades de esa frase se aplica a tu idea te ahorra créditos.
Esta guía trata sobre el comportamiento del modelo en tomas específicas de rap. No es un benchmark y no está afiliada al creador del modelo. Todo lo que sigue proviene de los tipos de toma que este estudio expone y de los modos de fallo que esas tomas producen.
En qué es bueno el modelo
Luz y atmósfera. Las luces prácticas de color, la neblina, la luz de contorno y las superficies mojadas se renderizan de forma convincente. Un escenario de club o una azotea de noche le dan al modelo suficiente información visual para construir una habitación creíble.
Tela y silueta. Las sudaderas con capucha, las chaquetas y la ropa holgada se mueven con el cuerpo. Eso importa en los visuales de rap, donde la silueta a menudo transmite tanta actitud como la cara.
Un solo movimiento de cámara. Un avance, un travelling lateral o una órbita lenta funcionan cuando el sujeto permanece en el encuadre. El movimiento es lo bastante fluido como para sentirse dirigido en lugar de generado.
Beats de interpretación cortos. Un gesto con la cabeza, un ademán, un paso hacia la cámara, un giro hacia el objetivo. Estos se leen con claridad en cinco a doce segundos, que es exactamente el formato que vende el estudio.
En qué es débil
Texto. Los carteles, las etiquetas, los tatuajes con letras y las letras en pantalla se degradan. El modelo puede producir algo que parece texto de lejos y se convierte en sinsentido de cerca. Por esta razón, cada preset excluye el texto legible.
Manos en primer plano. Los dedos son el fallo más común. Mantén las manos sobre un micrófono, en un bolsillo o moviéndose lo bastante rápido como para que el espectador no las estudie.
Sincronización labial precisa. El modelo no recibe tu pista vocal y no puede sincronizarse con ella. Un clip de interpretación parece una interpretación; no parece doblado. Añade la pista en un editor y corta alrededor del desajuste.
Continuidad de múltiples tomas. Un render es una toma. Pedir un corte, un cambio de ubicación y un cambio de vestuario en el mismo clip produce una papilla. Genera tomas separadas y edítalas.
Personas reales e identificables. Las solicitudes que involucran a celebridades o figuras públicas se rechazan, y no se permite usar la imagen de una persona real sin consentimiento. Sube solo a personas que hayan aceptado aparecer.
Los tipos de toma que encajan con el modelo
Los presets se eligen en torno a las fortalezas del modelo, no en torno a una lista arbitraria de tropos de videos musicales:
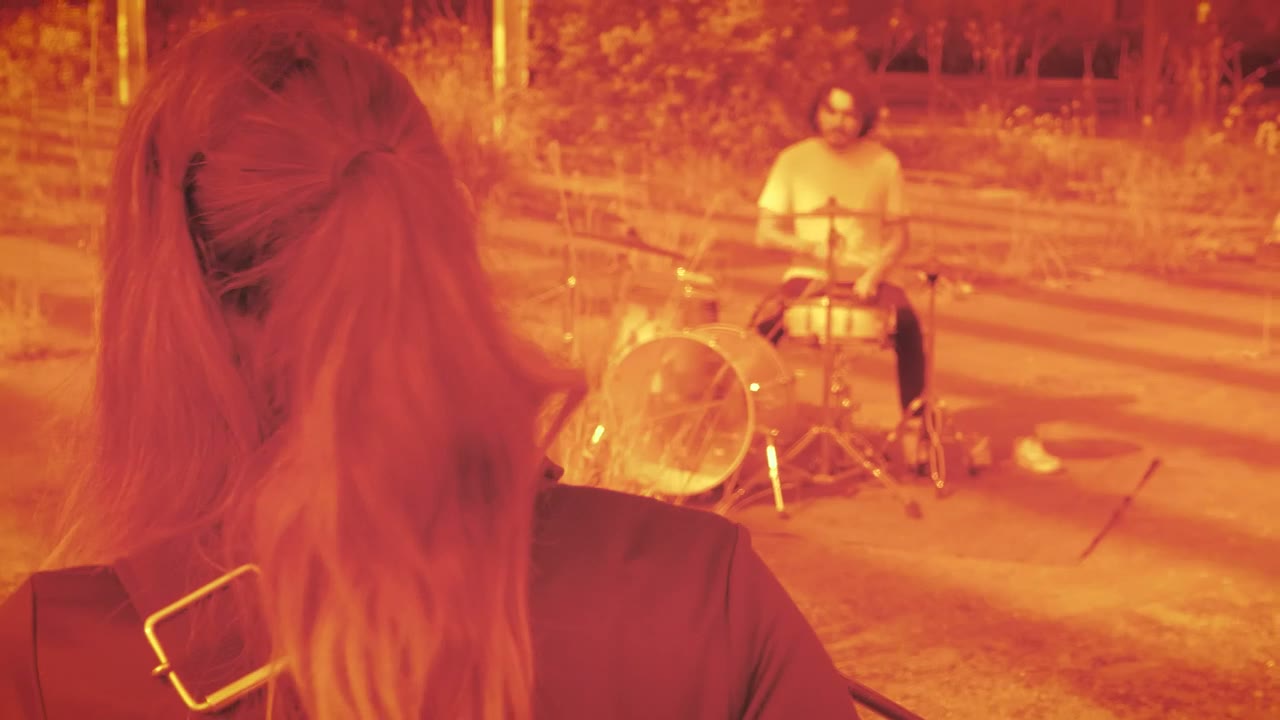
- Plano de dos en el club. Dos intérpretes, una multitud en silueta, un avance de cámara en mano. El fondo está cargado pero las caras son grandes.
- Primer plano en la cabina. Un intérprete, un micrófono, luz cálida principal y contorno frío. La prueba de identidad más simple y la toma más fiable.
- Cypher en la azotea. Un líder, un círculo de siluetas, luz de sodio sobre concreto mojado. Suficiente construcción de mundo sin pedir caras individuales de la multitud.
- Acera retro. Dos intérpretes, un boombox, grano de película cálido. El detalle de época se limita a objetos que el modelo puede sostener: ladrillo, ropa, un boombox.
Cada uno mantiene bajo el número de piezas en movimiento. Ese es el principio de diseño: menos objetos, menos identidades, un movimiento de cámara.
Escribir prompts a favor del modelo, no en su contra
Escribe la toma en el orden en que el modelo le da peso: sujeto, lugar, luz, cámara, restricciones. Pon la instrucción de identidad al principio y repítela al final. Usa lenguaje físico sencillo — "luz principal cálida de tungsteno desde la izquierda", "dolly-in lento", "a la altura del pecho" — en lugar de etiquetas estéticas.
Evita los prompts solo negativos. "Sin desenfoque, sin distorsión" no le dice al modelo qué renderizar. Di qué hay, luego di qué no debe aparecer. Los presets hacen ambas cosas.
Mantén el clip corto cuando estés probando. Un render de cinco segundos a 720p es la forma más barata de aprender si una foto y una escena funcionan juntas. Una vez que la identidad se mantiene, vuelve a renderizar el ganador más largo y a una resolución mayor.
Semejanza: qué esperar
El modelo usa tu foto como referencia, no como escaneo. Un retrato nítido y de frente produce una semejanza fuerte. Una foto suave, una cara cubierta o un filtro pesado producen deriva, y ninguna cantidad de texto en el prompt arregla una imagen de origen que ya ha perdido la información.
La mejora más fiable es una mejor foto: luz uniforme, ojos visibles, línea del cabello visible, expresión neutra. La segunda más fiable es un movimiento de cámara más lento. La tercera es una escena más simple. La redacción del prompt es la cuarta.
Costo y duración en la práctica
El estudio cobra por resolución y duración, y muestra el costo antes de enviar la tarea. Un clip estándar de doce segundos a 720p es la unidad de referencia en la página de precios. Los clips más cortos cuestan menos; 1080p cuesta más. No hay nivel gratuito, así que la vista previa y el precio forman parte de la misma decisión.
La mayoría de los clips terminan en un par de minutos. Un render a 1080p puede tardar más. Puedes salir de la página y volver; la tarea se guarda en tu cuenta.
Qué codifican los presets
Cada preset del estudio es un prompt completo, no un filtro. Duo Stage codifica dos intérpretes, un club, neblina, luces prácticas magenta y un avance de cámara en mano. Solo Booth codifica un intérprete, un micrófono, luz cálida principal y contorno frío, y un dolly lento. Night Cypher codifica un líder, un círculo de siluetas y luz de sodio sobre concreto mojado. Retro VHS codifica dos intérpretes, un boombox, grano cálido y un ligero halation.
Léelos como ejemplos resueltos. La estructura es consistente: sujeto, lugar, luz, cámara, restricciones. Una vez que ves ese patrón, puedes escribir un quinto preset sin adivinar a qué palabras responde el modelo.
Los prompts también muestran lo que no se le pide al modelo. Ninguno de ellos pide un corte, una letra, un logo o un primer plano con sincronización labial. Esas omisiones son deliberadas, y son la razón por la que los presets se renderizan de forma fiable.
Cuándo usar una herramienta diferente
Si necesitas una interpretación con sincronización labial sobre una vocal terminada, esta es la herramienta equivocada. Si necesitas un visualizador de diez minutos, genera un bucle y repítelo en un editor. Si necesitas un producto real, un local real o una multitud real, fílmala. Seedance es más fuerte cuando el mundo puede inventarse y el intérprete es lo único real en el encuadre.
Para el flujo de trabajo en torno al modelo, lee cómo hacer un video de rap con IA. Para los prompts, usa la biblioteca de 12 prompts.
Guías relacionadas
Cómo hacer un video de rap con IA a partir de una foto (Guía 2026)
El flujo de trabajo exacto para convertir un retrato en un clip de interpretación de rap: elige la foto, selecciona una escena, escribe una acción, renderiza, revisa y exporta.
Guía de video de dúo de rap con IA: dos caras, una escena
Cómo generar un video convincente de dúo de rap a partir de dos fotos: igualar la luz, el blocking, quién lidera, cómo evitar intercambios de caras y cómo cortar el resultado.
12 prompts de videos de rap con IA que realmente funcionan
Doce prompts listos para copiar y pegar para clips de interpretación de rap: escenario de club, cabina, cypher, acera retro, azotea drill, base de letra y más, con las protecciones que mantienen los rostros estables.